IA : où sont les preuves de la valeur créée ?
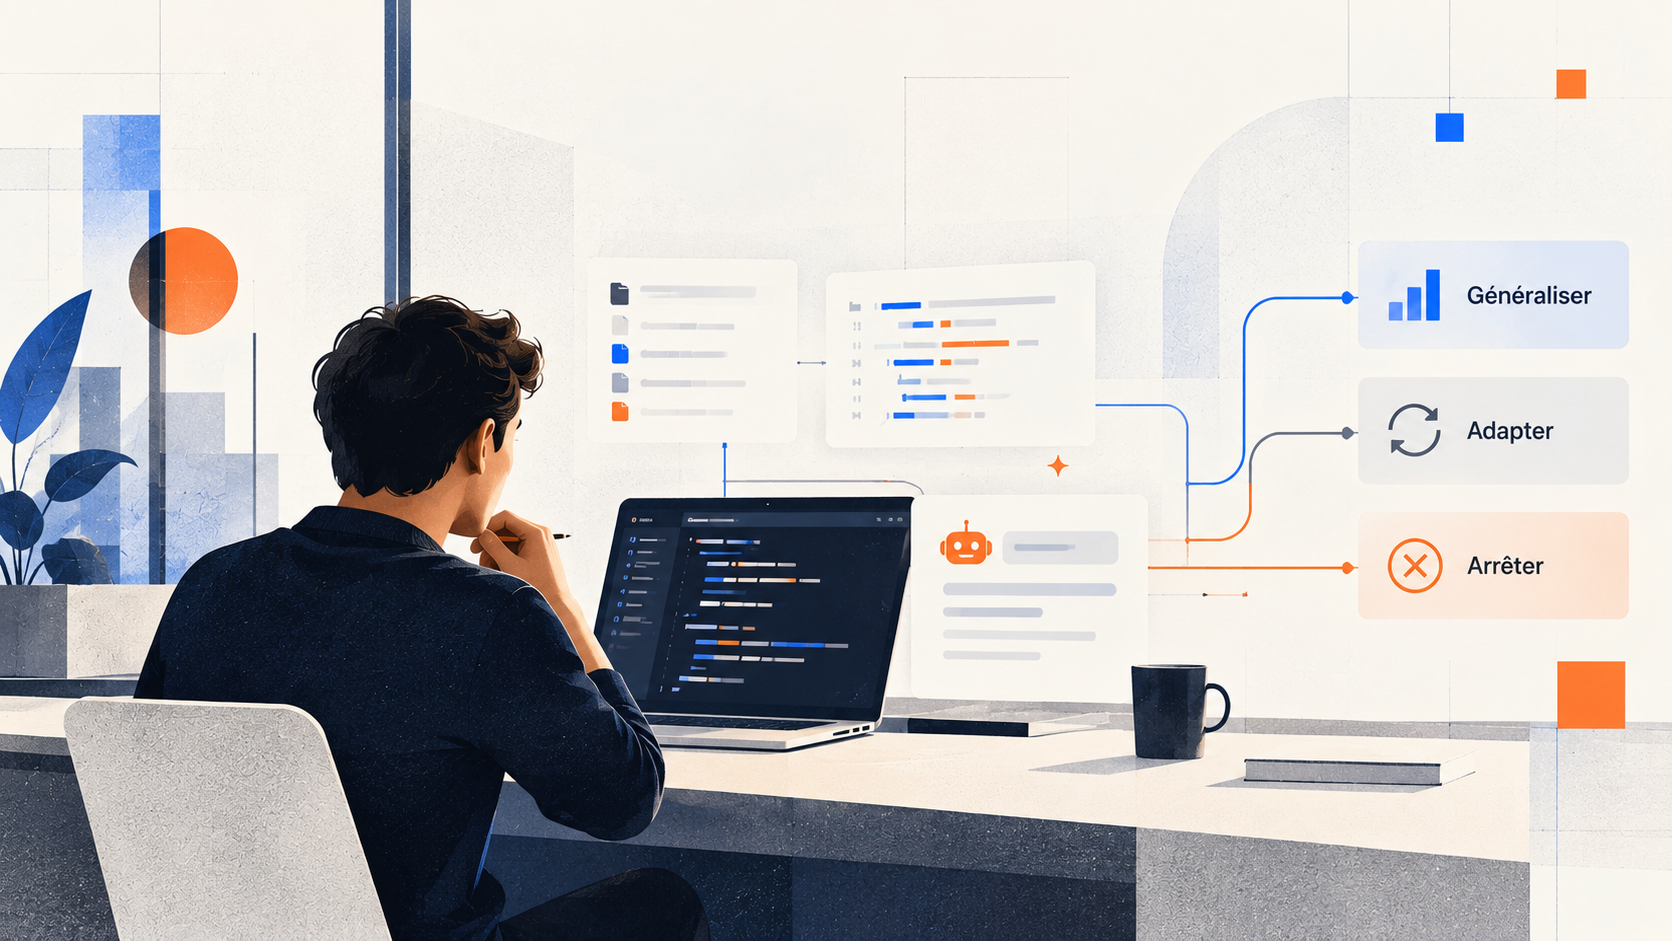
La preuve de valeur d'un usage de l'IA se définit avant son déploiement, avec un résultat attendu, une situation de référence, un horizon d'observation et des critères permettant de décider de sa généralisation, de son adaptation ou de son arrêt.
Mesurer l'usage de l'IA sans en démontrer la valeur
En 2026, l'équipe DORA de Google Cloud a publié un cadre pour évaluer le retour sur investissement de l'IA dans le développement logiciel. Son calculateur prend en compte les coûts des outils, les gains de productivité et la capacité de réinvestissement des équipes. Il permet d'estimer un bénéfice économique à partir de plusieurs hypothèses, sans pouvoir vérifier que les gains annoncés se traduisent effectivement dans les résultats de l'organisation.
Cette difficulté se retrouve dans les entreprises qui commencent à déployer des agents au sein de leur SDLC. Elles savent mesurer le nombre de développeurs équipés, l'utilisation des outils, les tâches automatisées ou le temps gagné sur certaines activités. Les équipes constatent des améliorations dans la génération de code, la préparation des tests ou la documentation, et les premiers retours justifient souvent d'étendre les expérimentations. Mais lorsqu'il faut démontrer ce que ces investissements ont apporté, les indicateurs disponibles ne répondent pas toujours à la question.
Définir ce que l'IA doit réellement améliorer
Prenons une équipe qui déploie des agents pour accompagner ses développeurs dans la production du code et l'automatisation des tests. Les premiers résultats sont encourageants. Les développeurs terminent certaines tâches plus rapidement, les agents prennent en charge une partie du travail répétitif et l'équipe déclare gagner du temps.
Ces résultats permettent de vérifier l'utilité des outils, mais leur interprétation dépend de l'objectif initial. Si l'entreprise cherchait à réduire le délai de livraison de nouvelles fonctionnalités, elle doit observer si les évolutions arrivent effectivement plus tôt en production. Si elle souhaitait améliorer la qualité du logiciel, elle doit suivre les défauts détectés, les incidents en production et les corrections nécessaires. Si l'enjeu était économique, elle doit être capable de rapprocher les gains des coûts d'acquisition, d'exploitation et de supervision des agents.
Une même expérimentation peut ainsi produire des gains sur certaines tâches sans atteindre le résultat pour lequel elle a été financée. Elle peut aussi générer des bénéfices inattendus qui méritent d'être étudiés, sans pour autant conduire à redéfinir systématiquement les critères de réussite après coup.
La première exigence consiste donc à formuler, avant le déploiement, ce qui devra avoir changé pour considérer que l'investissement est pertinent. Un objectif suffisamment précis doit permettre de comparer une situation initiale à des résultats observés sur une période donnée.
Vérifier les effets plutôt que justifier le déploiement
La difficulté apparaît lorsqu'une organisation cherche à évaluer la valeur de l'IA une fois les outils largement déployés. Les chiffres d'adoption progressent, les enquêtes internes indiquent des gains de temps et les développeurs apprécient les nouvelles possibilités offertes par les agents. Ces indicateurs sont utiles pour piloter le déploiement, mais ils peuvent conduire à présenter une expérimentation comme réussie alors que son effet sur les résultats attendus reste incertain.
Imaginons que notre équipe ait pour objectif de réduire le délai de mise en production. Après plusieurs mois, les activités de développement sont effectivement accélérées, mais le délai global n'a pas évolué dans les proportions attendues. Les gains sont peut-être réels, mais ils ne suffisent pas à justifier une généralisation si celle-ci repose principalement sur la promesse d'une livraison plus rapide.
L'évaluation doit alors permettre d'identifier les mécanismes en cause. Une partie du temps économisé peut avoir été consacrée à davantage de vérifications, les gains peuvent rester limités à certaines catégories de tâches ou les conditions de travail avoir évolué pendant l'expérimentation. Une comparaison avec la situation initiale, et lorsque c'est possible avec des équipes aux conditions proches, apporte des éléments plus fiables qu'une simple déclaration de productivité.
Cette discipline devient particulièrement importante lorsque les décisions portent sur plusieurs centaines de développeurs, des engagements contractuels ou des investissements récurrents. Plus les conséquences économiques sont importantes, plus la preuve attendue doit être solide.
Prévoir dès le départ la possibilité d'arrêter
Un pilote IA devrait permettre de décider si l'usage mérite d'être généralisé, adapté ou abandonné. Ces trois issues doivent être envisagées dès son lancement, avec des critères d'évaluation cohérents avec les objectifs poursuivis.
Dans notre exemple, si les agents améliorent certaines tâches mais n'apportent pas les bénéfices attendus au regard de leur coût, l'entreprise peut réserver leur utilisation aux activités où les gains sont démontrés. Elle peut également modifier les pratiques de développement, prolonger l'expérimentation lorsque les résultats restent prometteurs ou décider de ne pas étendre le déploiement.
L'arrêt d'un usage ne signifie pas nécessairement que la technologie est inefficace. Il peut simplement montrer qu'elle n'apporte pas suffisamment de valeur sur le périmètre concerné, dans les conditions actuelles d'utilisation. Ce résultat constitue un apprentissage utile s'il intervient avant une généralisation coûteuse.
Pour autant, une expérimentation ne peut remplir cette fonction que si les responsables acceptent de confronter les résultats à l'hypothèse initiale, y compris lorsque l'adoption est bonne et que les équipes souhaitent conserver les outils.
À mesure que les capacités des agents progressent, les possibilités d'automatisation vont continuer à se multiplier. Les entreprises auront davantage d'usages à évaluer et devront faire des choix entre des investissements qui ne produiront pas tous les mêmes bénéfices.
Il devient donc nécessaire d'associer à chaque expérimentation un résultat attendu, une situation de référence, un horizon d'observation et des critères permettant de décider de la suite. Cette discipline doit rester proportionnée à l'investissement, sans transformer chaque usage en protocole de recherche.
Une organisation qui veut piloter l'IA par la valeur doit aussi savoir interrompre les usages qui ne produisent pas les résultats attendus, même lorsque les outils fonctionnent et que leur adoption progresse. Cette possibilité doit être prévue dès le lancement du pilote et réellement exercée lorsque les observations le justifient.
Sources
- Google Cloud, DORA, ROI of AI-assisted Software Development, 2026, et calculateur associé — Calculateur : https://dora.dev/ai/roi/calculator/